
El jueves 12 de noviembre, pasada la una de la tarde en Santiago, mucha gente se dio cuenta de que Outlook no cargaba. Al rato tampoco funcionaban bien Teams, OneDrive, Copilot ni las consolas de administración. Lo que partió como "se cayó el correo" terminó, en palabras de TechCrunch, convertido en una crisis global de la nube de Microsoft. Exchange Online estuvo afuera casi 24 horas.
El domingo 15, Microsoft envió a sus clientes un informe preliminar del incidente. Por lo que reportan The Register y TechCentral, es un documento que cualquier equipo que opere sistemas críticos debería discutir. No por el morbo de ver caer a un gigante, sino porque casi todo lo que salió mal ahí nos puede pasar a nosotros, a cualquier escala.
Qué pasó, en orden
Resumo la secuencia según lo que reportan ambos medios citando el informe:
- Julio de 2026. Microsoft prepara un cambio específico para los servidores de un gateway de red que está delante de muchos servicios de Microsoft 365: recibe las conexiones de los usuarios y las pasa a Exchange y compañía. El cambio pasa las pruebas de carga y se despliega por etapas en todo el mundo. Según el informe, durante más de tres meses funcionó "sin impacto".
- El defecto que nadie vio. Bajo ciertas cargas, el cambio provocaba contención de locks dentro de un proceso interno de Windows: tareas esperando unas por otras hasta agotar CPU y memoria. El problema empeora en máquinas nuevas con más núcleos. Y las pruebas de carga, admite Microsoft, "tendían a enfocarse en hardware más débil, con menos núcleos".
- Dos condiciones normales al mismo tiempo. En la madrugada del 12 (hora UTC), el tráfico de Teams se movió automáticamente desde un gateway alternativo al gateway principal que también atiende a Exchange Online, algo que Microsoft describe como parte normal de la operación. Además, cerca del 14% de la capacidad de ese gateway estaba fuera de servicio por un problema no relacionado del día anterior. Ninguna de las dos cosas, por separado, era un problema.
- La cascada. Con más carga y menos servidores, el defecto se gatilló en horario peak de Estados Unidos. Los servidores que dejaban de responder eran sacados de rotación, y su tráfico se iba a los sanos, que caían por la misma razón. En menos de dos horas, más del 80% de los servidores del gateway estaba sin responder. Las barreras entre celdas, diseñadas justamente para que una falla local no se propague, no aguantaron "por un problema separado" que el informe preliminar no explica.
- La recuperación que no recuperaba. Cada servidor que volvía era aplastado de inmediato por el tráfico acumulado y caía otra vez. Los procesos automáticos de recuperación "no estaban diseñados para restaurar el servicio desde este estado". Y como el cambio defectuoso tenía meses, las herramientas habituales de rollback no servían para deshacerlo rápido.
- La salida. Unas 15 horas después de la primera alerta, los ingenieros empezaron a aplicar una actualización que devolvía ese camino de código a su estado anterior, por grupos de servidores, priorizando las regiones que entraban en horario laboral.
Teams, OneDrive y SharePoint pudieron sacar su tráfico del gateway con problemas y se recuperaron antes. Exchange Online no pudo, "por razones de escala".
Una falla latente no es un bug más
Lo que más me hace pensar de este incidente es el punto 1. Estamos acostumbrados a asociar los incidentes con el último cambio: algo se rompe, miramos qué se desplegó en las últimas horas y lo revertimos. Canary, monitoreo post-deploy y botón de rollback están armados para eso.
Una falla latente rompe ese modelo. El cambio pasó todas las compuertas. El despliegue por etapas no detectó nada porque no había nada que detectar con la carga de esos días. Y cuando la falla finalmente apareció, el cambio ya no era "reciente": había decenas de cambios encima, y no era evidente cuál era el culpable. De hecho, Microsoft tardó varias horas en identificar que el problema estaba en la negociación de conexiones.
La lección incómoda es que el despliegue progresivo valida un cambio contra la carga que hubo durante el despliegue, no contra la carga que podría haber. Si el defecto solo aparece en el percentil 99,9 de condiciones (peak de tráfico, capacidad reducida, failover en curso), el canary no lo va a ver. Lo va a ver producción, el peor día posible.
Redundancia homogénea: el failover como vector de contagio
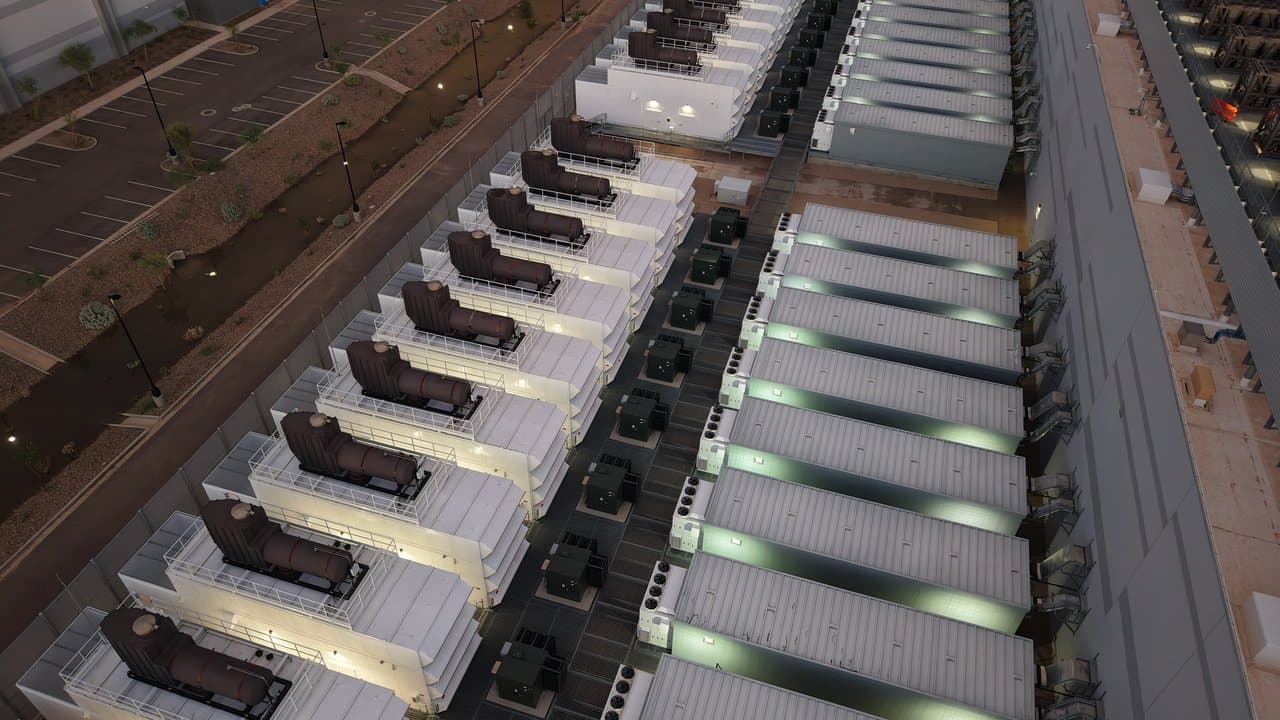
El segundo punto es más conocido, pero aquí se vio de forma muy limpia. El failover funcionó exactamente como estaba diseñado: un nodo deja de responder, su tráfico se reparte entre los sanos. El problema es que todos los nodos tenían el mismo defecto. Repartir la carga entre servidores idénticos que fallan por sobrecarga no es redundancia; es una forma eficiente de contagiar la falla.
Es la idea de modos de falla comunes que comenté sobre el corte de Google Cloud en Londres, pero esta vez el componente compartido era una línea de código.
Servidores idénticos, fila tras fila, en el centro de cómputo de Fermilab. Foto: U.S. Department of Energy, dominio público, vía Wikimedia Commons.
Ese diagrama tiene dos ciclos, y los dos se refuerzan solos. Es lo que en sistemas distribuidos se conoce como un estado metaestable: una vez que el sistema entra, sale solo si alguien corta el ciclo desde afuera, aunque la causa original (el poco de carga extra) ya haya desaparecido. Agregar capacidad, que se intentó durante la noche, no basta si cada servidor nuevo entra al mismo ciclo.
El rollback tiene fecha de vencimiento
El tercer punto es el que creo que más equipos subestiman. "Si algo sale mal, hacemos rollback" es una frase que he escuchado en muchísimos comités de cambio. Funciona bien las primeras horas o días. Pero un rollback depende de que el estado anterior siga existiendo y siga siendo compatible con todo lo que se desplegó después. Con el paso de las semanas, revertir un cambio deja de ser apretar un botón y pasa a ser un desarrollo nuevo, con su propio riesgo.
Microsoft terminó haciendo justamente eso: un parche que devolvía el código a su comportamiento anterior. En medio de un incidente global, con todo el mundo mirando.
Lo que yo llevaría a la mesa
La conclusión no es "dejemos de usar SaaS". Cualquier organización que opere a escala tiene defectos dormidos en producción ahora mismo. Lo que sí propondría a cualquier equipo que opere algo crítico:
Probar carga en el hardware que de verdad corre en producción. El ambiente de pruebas de rendimiento suele ser el pariente pobre: máquinas más antiguas y chicas, "para no gastar". Aquí el defecto era peor justamente en el hardware más nuevo.
Probar las combinaciones, no solo los escenarios. "Perdemos el 14% de capacidad" y "llega el tráfico de un failover" probablemente estaban, cada uno, en algún plan de pruebas. Lo que mata es la conjunción. Los ejercicios de caos y las pruebas de carga deberían incluir escenarios compuestos: capacidad reducida más pico más failover.
Poner límites al failover. Un sistema que redistribuye carga sin techo puede convertir una falla parcial en una total. Mejor que los nodos sanos rechacen trabajo (load shedding, control de admisión) a que lo acepten todo y caigan. Es, de hecho, una de las medidas que Microsoft dice haber tomado después del incidente: limitar cómo se redistribuye la carga para evitar otra cascada.
Diseñar el arranque en frío. La pregunta "¿cómo levantamos el servicio si el 80% de la flota está abajo y hay una cola enorme esperando?" merece su propio runbook y, si es posible, su propio mecanismo: readmisión gradual de tráfico, prioridades, la posibilidad de mantener nodos fuera de rotación hasta que estén estables.
Cambios reversibles por diseño, no por rollback. Para cambios en componentes críticos, envolver el nuevo comportamiento en un feature flag o en una ruta de código que se pueda desactivar meses después sin redesplegar. Es más trabajo al principio, pero convierte el "parche del parche" en un cambio de configuración.
Verificar que las celdas aíslen de verdad. Aquí las barreras existían y no funcionaron. Eso no se descubre en un diagrama, sino rompiendo una celda a propósito.
Saber qué dependencias tuyas no pueden hacer failover. Exchange no pudo salir del gateway por razones de escala. En nuestra propia arquitectura casi siempre hay uno o dos componentes así. Conviene tenerlos identificados y con un plan de degradación, porque son los que determinan cuánto dura el incidente.
La pregunta para el proveedor y la pregunta para nosotros
Un último detalle revelador: según TechCentral, los créditos del SLA de Exchange Online se calculan sobre el fee mensual, son el "único y exclusivo remedio" y no cubren pérdidas. El proveedor te devuelve parte de lo que pagaste, no lo que perdiste. Es lo normal en la industria, y un buen recordatorio de que el SLA no es un plan de continuidad.
A los proveedores debemos exigirles transparencia e informes post-incidente. Pero la pregunta que más vale la pena hacerse no es "¿por qué falló Microsoft?", sino "¿qué falla dormida tengo yo en producción y qué combinación de días normales la va a despertar?". Como escribí hace un tiempo, diseñar para el fracaso no es pesimismo: es asumir que el día malo va a llegar y decidir de antemano cómo queremos que se comporte el sistema cuando llegue.
Microsoft prometió el informe final para el 20 de noviembre. Lo voy a leer buscando ese "problema separado" que dejó pasar la cascada entre celdas: ahí, sospecho, está la lección más valiosa.