
El martes 20 de octubre, a las siete de la mañana en Londres, mucha gente intentó pagar el café con la tarjeta de Revolut y no pudo. Tampoco podía sacar plata del cajero, hacer transferencias ni recargar la tarjeta. Clientes de Lloyds y HSBC tenían problemas para entrar a sus apps. Durante unas seis horas, una parte importante de la banca británica quedó, para efectos prácticos, fuera de servicio.
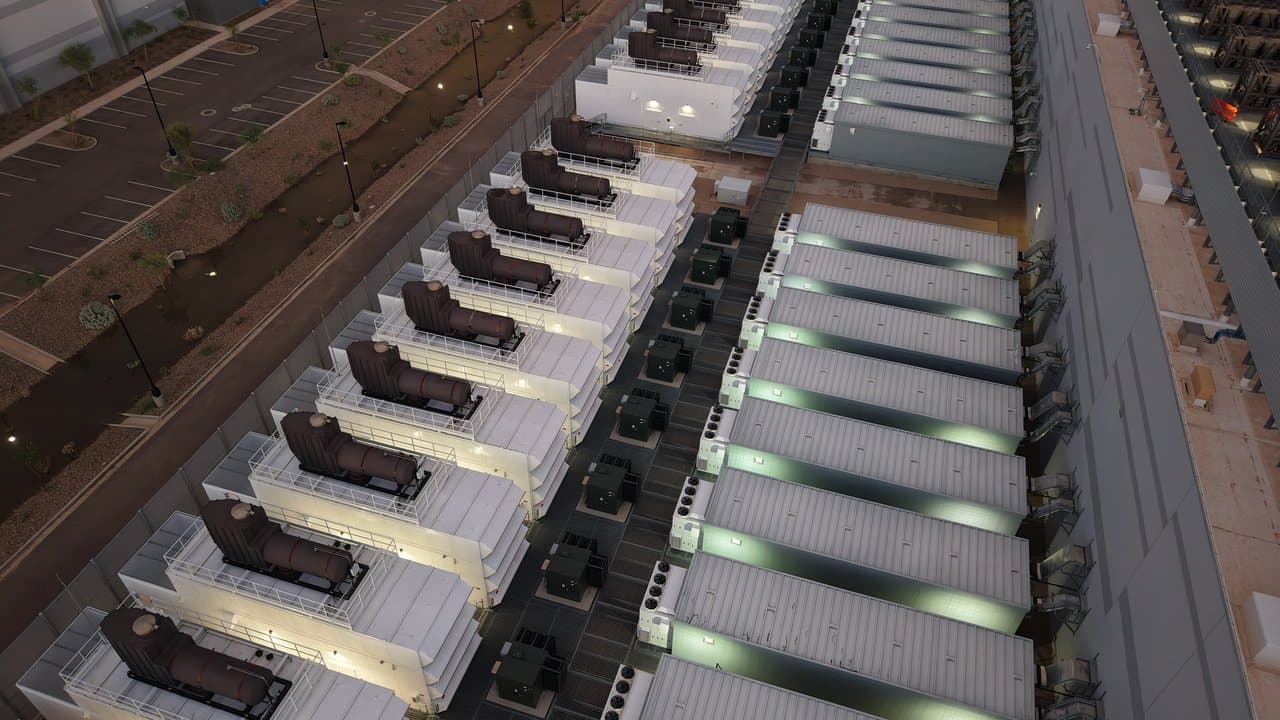
La causa no fue un ataque, ni un bug en un despliegue, ni un error humano en una configuración. Fue un generador diésel que no arrancó.
Vale la pena mirarlo con calma, porque es de esos incidentes que se leen rápido como "se cayó la nube" y se archivan. Y creo que tiene bastante más que enseñar a quienes diseñamos sistemas financieros, sobre todo en un país como Chile, donde la migración de cargas críticas a la nube pública ya no es una discusión sino una realidad.
Qué pasó, según el propio informe de Google
Google publicó un informe preliminar del incidente bastante detallado. La secuencia, resumida, es esta:
- Hubo una interrupción de la red eléctrica en el datacenter que aloja la zona de disponibilidad
europe-west2-b. - La carga pasó, como corresponde, a las baterías UPS mientras partían los generadores de emergencia.
- El sistema de automatización que debía ordenar el arranque y la transferencia a los generadores (un PLC, programmable logic controller) falló. Y no solo el primario: también el de respaldo.
- Cuando se agotaron las baterías, los servidores, la red y el almacenamiento de esa zona se apagaron.
- El tráfico se fue, automáticamente, hacia las otras zonas de la región. Y ahí vino el segundo golpe: la avalancha de cargas redirigidas, failovers de bases de datos y trabajos de cómputo saturó la capacidad de las zonas que seguían vivas, con colas de admisión, failovers que tardaban en completarse y errores 500 y 503 en toda la región.
En total, 6 horas y 10 minutos de degradación. El corte afectó a Revolut, Lloyds y HSBC, entre otros, y según la BBC también golpeó sitios web y otros servicios en el Reino Unido.
Lo que más me llama la atención es el punto 5. Una zona caída es un escenario que todo el mundo dice tener cubierto. Lo que muchos no tienen cubierto es lo que pasa en las zonas que quedan cuando todos sus vecinos intentan mudarse a la misma casa al mismo tiempo.
Tres zonas no son tres salvavidas
Durante años, la respuesta estándar a "¿qué pasa si se cae el datacenter?" en arquitecturas cloud ha sido: "estamos en multi-AZ". Despliegue en tres zonas de disponibilidad, balanceador al frente, base de datos con réplica sincrónica, y listo.
Es una buena base. Pero el incidente de Londres muestra tres supuestos que solemos dar por sentados y que no siempre se cumplen:
1. Que las zonas son independientes en todo. Lo son en energía y red física, por diseño. Pero el informe menciona que los planos de control regionales hacían llamadas a componentes de metadatos y catálogo que vivían en la zona caída, y que esas llamadas empezaron a expirar. Es decir: había dependencias cruzadas que no se veían hasta que la zona desapareció. Si eso le pasa al proveedor, que diseña su infraestructura con un nivel de rigor enorme, es razonable suponer que también nos pasa a nosotros con nuestros propios servicios.
2. Que la capacidad de reserva existe cuando la necesitas. Diseñar para N+1 zonas sirve solo si las otras zonas pueden absorber la carga de la que se cayó. Si cada zona corre al 70% en régimen normal, perder una significa pedirle a las otras dos que corran al 105%. Y no eres el único cliente que va a pedir esa capacidad en ese mismo minuto. El failover no es gratis: es una competencia por recursos con todos los demás clientes de la región.
3. Que el respaldo del respaldo funciona. El PLC primario y el de respaldo fallaron juntos. Es el clásico problema de los modos de falla comunes: dos componentes redundantes que comparten diseño, software o condiciones tienden a fallar por la misma razón y al mismo tiempo. Redundancia sin diversidad es, muchas veces, la misma falla duplicada.
Nada de esto es nuevo en teoría. Lo nuevo es verlo ocurrir, documentado, en un proveedor de primer nivel y con bancos grandes en la línea de fuego.
La responsabilidad no se externaliza
Hay una frase en la nota de Reuters que, como arquitecto de banca, me parece la clave de todo: bajo las reglas británicas, los bancos son en último término responsables de los servicios que entregan a sus clientes, incluso cuando dependen de terceros.
Es decir, para el cliente que no pudo pagar en el supermercado da lo mismo si el problema fue un PLC en un datacenter de Londres. El que no cumplió fue su banco.
La reacción regulatoria fue inmediata. La Autoridad Bancaria Europea contactó a Google para entender el impacto en entidades de la Unión Europea, la FCA británica dijo que estaba trabajando con Google, y el Comité del Tesoro del Parlamento británico escribió ese mismo día al Banco de Inglaterra y a la FCA para preguntar cómo van a usar sus nuevas facultades. Contexto importante: en julio, el Reino Unido designó a Microsoft, Google Cloud, AWS y Oracle como proveedores críticos del sector financiero, y la Unión Europea había hecho algo similar el año anterior con 19 empresas tecnológicas. Este corte es, según Reuters, la primera gran prueba de esos regímenes.
Lo interesante es que esos marcos supervisan al proveedor, pero no le quitan la responsabilidad al banco. Es una lógica de dos capas: el regulador vigila que el proveedor sea robusto, y el banco sigue obligado a diseñar como si el proveedor pudiera fallar. Porque va a fallar.
¿Y en Chile?
En Chile, la referencia es el Capítulo 20-7 de la Recopilación Actualizada de Normas de la CMF, sobre externalización de servicios. Su sección sobre nube es bastante clara: el directorio del banco debe pronunciarse cada año sobre la tolerancia al riesgo que está dispuesto a asumir en este tipo de externalizaciones, y si el servicio es estratégico o crítico, la entidad debe hacer una diligencia reforzada del proveedor: prestigio y experiencia, certificaciones internacionales de seguridad y continuidad de negocio, contratos directos, informes legales sobre las jurisdicciones involucradas, auditorías disponibles, aislamiento y cifrado. La CMF además ha estado actualizando ese capítulo este año.
Me parece una buena base, y en la práctica obliga a los equipos a tener conversaciones serias antes de mover algo crítico. Pero leyendo el incidente de Londres, siento que la diligencia sobre el proveedor es solo la mitad del trabajo. La otra mitad es la diligencia sobre nuestra propia arquitectura: cómo se comporta lo que construimos encima del proveedor cuando el proveedor tiene un mal día.
Un datacenter puede tener todas las certificaciones del mundo y aun así tener un PLC que no arranca. La certificación te dice que el proveedor tiene procesos; no te dice cómo se va a comportar tu sistema de pagos cuando una zona desaparezca a las siete de la mañana.
Lo que yo pondría sobre la mesa
Si me tocara llevar este incidente a un comité de arquitectura, no propondría "salgámonos de la nube" ni "vamos a multi-cloud para todo". Ambas respuestas son caras y, mal hechas, agregan más riesgo del que quitan. Propondría cosas más concretas:
Probar la pérdida de una zona de verdad, no en una planilla. Apagar una zona completa en un ambiente representativo y medir qué pasa: cuánto tarda el failover, qué dependencias cruzadas aparecen, qué servicios se quedan esperando un timeout que nadie configuró. Lo que no se ensaya, no existe.
Reservar capacidad para el día malo. Si el plan de continuidad depende de levantar instancias en otra zona durante el incidente, el plan depende de que haya capacidad disponible en el peor momento posible. Para los servicios verdaderamente críticos, la capacidad de reserva debería estar ya provisionada o, al menos, garantizada contractualmente.
Diseñar la degradación, no solo la recuperación. No todo tiene que funcionar al 100% durante una falla. Pero el cliente debería poder hacer lo esencial: pagar con su tarjeta, ver su saldo. Eso implica decidir con anticipación qué funciones se apagan primero para proteger las que importan, en vez de dejar que el sistema completo compita por los recursos que quedan.
Evaluar cuándo una sola región no basta. Para algunos servicios, el escenario de diseño no debería ser "se cae una zona" sino "se degrada la región entera". Eso tiene un costo alto en complejidad y en consistencia de datos, así que no es para todo. Pero para el puñado de servicios que, si se caen, son noticia, la conversación hay que tenerla.
Llevar el riesgo de concentración al directorio, con números. La norma ya pide que el directorio se pronuncie sobre la tolerancia al riesgo. Lo que yo agregaría es hacerlo con escenarios concretos: "si la región donde corre nuestro sistema de tarjetas se degrada seis horas, este es el impacto, este es el plan y esto cuesta reducirlo". Seis horas es exactamente lo que acaba de pasar en Londres. Ya no es un escenario hipotético.
La nube no falló; falló un supuesto
Sería injusto leer este incidente como un argumento contra la nube pública. Los datacenters propios también tienen generadores que no parten, y la mayoría no publica un informe detallado al día siguiente. La transparencia de Google, de hecho, es lo que nos permite aprender algo.
Lo que falló fue un supuesto: que la redundancia del proveedor es nuestra resiliencia. No lo es. La resiliencia es una propiedad de nuestra arquitectura, y se demuestra en cómo se comporta el sistema completo cuando una pieza que no controlamos deja de funcionar.
La banca se ha pasado décadas construyendo confianza sobre una idea simple: tu plata está disponible cuando la necesitas. Esa promesa no se puede subcontratar. Se puede apoyar en un proveedor, sí, pero el diseño para el día en que el proveedor falle sigue siendo trabajo nuestro.